データセット
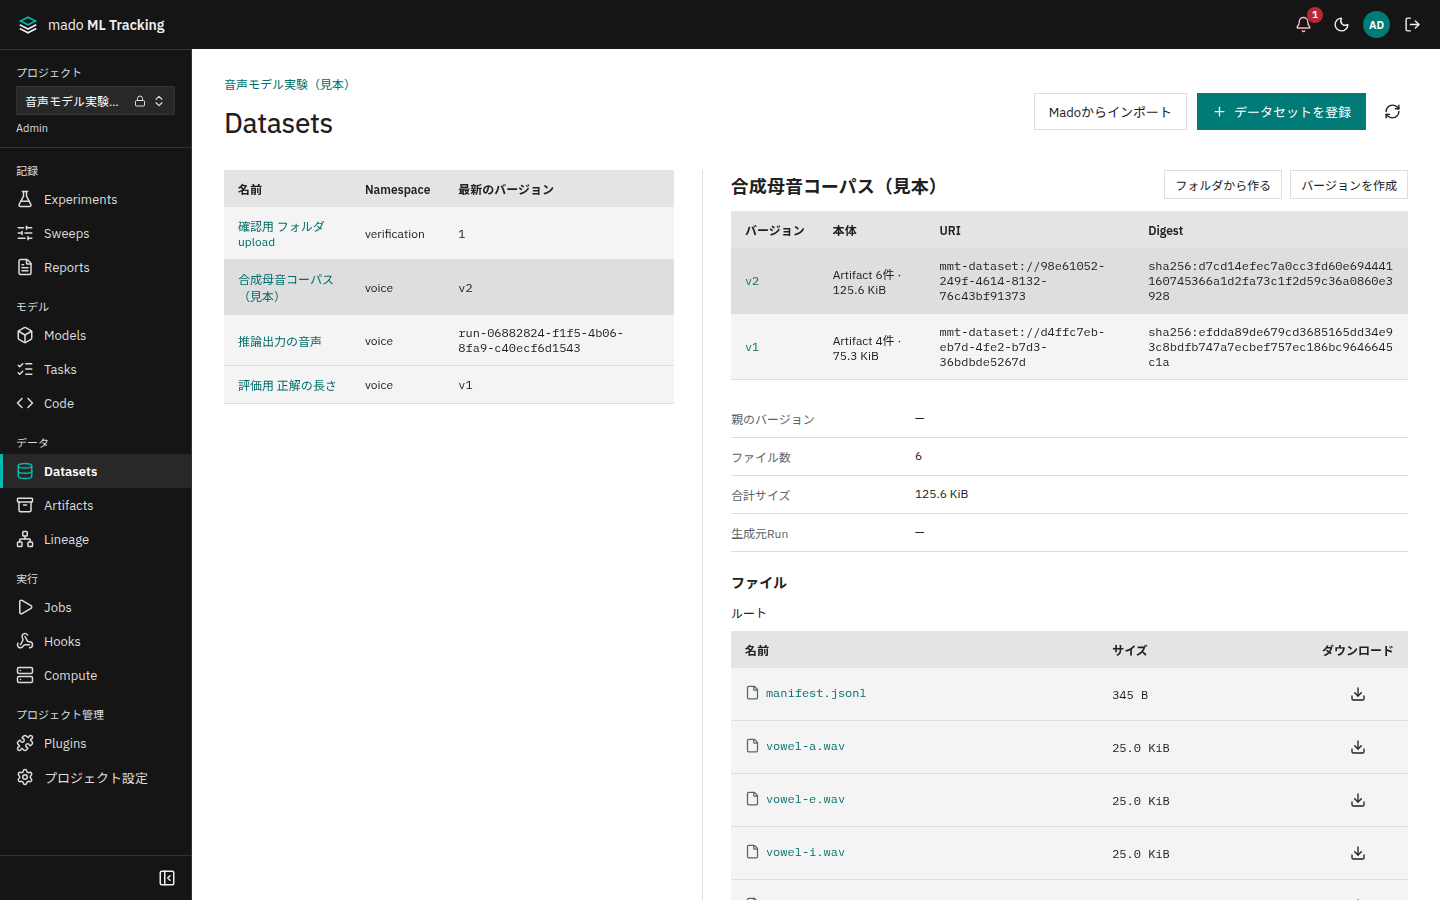
データセットは、学習や評価に使うデータの集まりです。中身が変わるたびに新しいバージョンを作り、Runには「どのバージョンを使ったか」を記録します。バージョンは作成したあとに変更できないので、あとから同じバージョンで学習や評価をやり直せます。
バージョンの本体は、mado ML TrackingにArtifactとして保存したファイルか、外部の場所を指すURIのどちらかです。Runの入力にしたバージョンは、workerが実行の前にGPUマシンへ用意します。
こんなときに向いています
- 手元の音声コーパスのフォルダを、そのままバージョンとして登録したい
- 推論の出力を、次の評価の入力に使えるバージョンとして残したい
- どのモデルバージョンがどのデータで学習したかを、Lineageでたどりたい
- GPUマシンからAPIへ直接つながらなくても、学習データをGPUマシンへ送りたい
- Madoで管理しているデータセットのバージョンを、実験の入力に使いたい
バージョンの種類
| 種類 | 本体 | 作り方 |
|---|---|---|
| Artifactを本体とするバージョン | 保存したArtifactの一覧。バージョンの一覧に「Artifact N件 · サイズ」と表示されます | フォルダから作る、Python SDK、Runの出力 |
| 参照のバージョン | URI(s3://、https://、file://など)とdigest。一覧に「参照(URI)」と表示されます | [バージョンを作成]、MLflowのlog_input、Madoからのインポート |
Artifactを本体とするバージョンは、ファイルのパス、SHA-256、サイズの一覧から計算したdigest(sha256:<hex>)を持ちます。同じ中身のファイルを上げ直すと、同じdigestになります。URIはmmt-dataset://<バージョンのID>です。
1つのバージョンのファイル数は10万件までです。
データセットを登録する
- サイドバーの[Datasets]を開きます
- [データセットを登録]を押します
- [名前](必須)、[Namespace]、[説明]を入力して保存します
Namespaceは、データセットを分類する名前です(例: voice)。[データセットを登録]は、editor以上のユーザーに表示されます。
データセットを選ぶと、名前の下にNamespaceと説明が出ます。説明はあとから、名前の横の[⋯]→[説明を変更]で直せます(editor以上)。名前は変えられません。SDKやMLflowが名前でデータセットを探すためです。
フォルダからバージョンを作る
ブラウザで選んだフォルダの中身をArtifactとしてアップロードし、全部の保存が終わったらバージョンを作ります。
- 一覧でデータセットを選び、[フォルダから作る]を押します
- [フォルダを選ぶ]を押すか、フォルダをドロップします
- 必要なら次の項目を入力します
- [バージョン(空なら自動採番)]: 空欄なら、
1、2のように整数で採番します - [親のバージョン]: このバージョンの元になったバージョン。このデータセットの最新のバージョンに、はじめからチェックが付いています。親にしないときは外します。バージョンが多いときは、上の欄で絞り込めます
- [Metadata(JSON)]: 例
{"language": "ja", "sampleRate": 16000}
- [バージョン(空なら自動採番)]: 空欄なら、
- [アップロードしてバージョンを作成]を押します
アップロードは大きなファイルのアップロードと同じ方法で送ります。進み具合は、フォルダ全体の棒(件数・バイト数・残り時間)と、送信中・一時停止・失敗のファイルの行だけで表示します。待機中と完了のファイルは件数だけを出します。行の名前は、データセットの中のパスです。
一部のファイルを送れなかった場合は、バージョンを作らずに止まります。[残りのファイルを再送]で送り直すか、[残りのファイルを除いてバージョンを作成]を選びます。バージョンの作成だけが失敗した場合は、[バージョンの作成を再試行]を押します。ファイルを送り直す必要はありません。
途中で止まったフォルダのアップロード
再読み込みや回線の切断、ダイアログを閉じたことで、バージョンを作る前に止まったアップロードは、もう一度[フォルダから作る]を開くと「途中のフォルダのアップロード」に出ます。行には始めた日時、保存済みのファイルの件数と大きさ、送りかけの大きなファイル(自分が送っていたもの)が出ます。
- 続きを送る: 行の[続きを送る]で同じフォルダを選ぶか、上の[フォルダを選ぶ]で同じフォルダを選びます。前回と同じパス・大きさのファイルがあると「〜に始めたアップロードの続きとして送ります」と出て、ボタンが[続きを送ってバージョンを作成]に変わります。始めると、保存済みのファイルの中身(SHA-256)を手元のファイルと照合し、同じものは送り直さずにそのまま使います。照合している間は[照合をやめる]で止めて、始める前の状態に戻せます(まだ何も送っていません)。送りかけの大きなファイルは、サーバーにあるpartの続きから送ります。続きにせず別に送るときは[新しく送る]を押します
- 破棄: [破棄]を押し、確認で[破棄]を押すと、保存済みのファイルのうちどのバージョンにも使われていないものを削除し、送りかけのアップロードを取り消します。保存済みのファイルを削除できるのはProject adminです。editorには[破棄]の代わりに「保存済みのファイルを消せるのは Project admin です」と出ます(送りかけだけのものは、editorも破棄できます)。モデルバージョン・コードバージョン・checkpointが使っているファイルは削除せずに残し、その件数と理由、残したファイルをArtifactsの一覧で見るボタンを出します。残したファイルがある間は、その行も一覧に残ります
保存済みのファイルは、Artifactsの一覧では「データセット 〈名前〉 途中のアップロード」として出ます。
作ったバージョンは、一覧で選ぶと「ファイル数」「合計サイズ」とファイルの一覧が表示されます。ファイルを選ぶと、Artifactと同じようにプレビューできます。
Python SDKでバージョンを作る
register_datasetのfilesにフォルダを渡すと、中身をアップロードしてバージョンを作ります。dataset_idを省略すると、nameでデータセットを新しく作ります。
from mado_tracking import Client

with Client() as client:
    version = client.register_dataset(
        "<Project ID>",
        name="speech-corpus",
        namespace="voice",
        files="data/speech",
        metadata={"language": "ja"},
)既存のデータセットにバージョンを足すだけなら、upload_dataset_directoryを使います。
from mado_tracking import Client
from mado_tracking.dataset_upload import upload_dataset_directory

with Client() as client:
    version = upload_dataset_directory(
        client, "<Project ID>", "<Dataset ID>", "corpus/",
        version=None,                 # Noneなら整数で自動採番
        metadata={"language": "ja"},
        schema={"sampleRate": 16000},
    )
SDKは、ファイルごとにSHA-256とサイズで同じ中身の保存済みArtifactを探し、見つかればアップロードせずにそれを使います。前のバージョンと大半のファイルが同じなら、変わったファイルだけを送ります。途中で止まった場合も、もう一度実行すると保存していないファイルだけを送ります。
filesを使うときは、uri、digest、source_run_id、parent_dataset_version_ids、external_refを指定しません。
URIを参照するバージョンを作る
ファイルを保存せずに、外部の場所を指すバージョンを作るときは、データセットを選んで[バージョンを作成]を押し、次の項目を入力します。
| 項目 | 入力する値 | 例 |
|---|---|---|
| バージョン | バージョンの名前(必須) | 2026-10 |
| URI | データの場所(必須)。s3://(バケットとキー、またはフォルダ)、https://(1つのファイル)、file://(実行先のコンピュータ上のパス) | s3://corpus/speech/2026-10/ |
| Digest | 中身のSHA-256(必須)。sha256:と64桁の小文字の16進数で書きます。sha256:は省けるので、sha256sumの結果の64桁をそのまま貼っても構いません。入力した形のまま保存します。大文字や桁数の違うもの、ほかの算法(sha512:など)は「digestは sha256:<64桁の小文字16進数>(sha256:は省略可)の形で指定してください」と断られます | sha256:<64桁の16進数>、またはsha256sumの結果の64桁 |
| 親のバージョン | 元になったバージョン | |
| 生成元Run | このバージョンを作ったRun | |
| Schema(JSON)、Metadata(JSON) | 任意のJSON | {"columns": ["audio", "text"]} |
Runの出力からバージョンを作る
推論や前処理のRunが出力したファイルを、そのまま次のRunの入力に使えるバージョンにできます。Runの出力から作ったバージョンは、生成元のRunが記録され、Lineageの「データ出力」の線でつながります。
- Taskで実行するコードでは、
/mmt/outputs/result.json(version 2)のdatasetsで出力を宣言します。workerが出力ファイルを保存したあとに、整数で採番したバージョンを登録します。宣言はRunごとに64件までです - Python SDKでは、
run.register_output_dataset(version=, uri=, digest=)で参照のバージョンを登録します。親のバージョンには、Runの入力のバージョンが入ります。digestは画面と同じくsha256:と64桁の小文字の16進数です(sha256:は省略可) - APIでは、
POST /api/projects/<Project ID>/datasets/<Dataset ID>/versionsのcontentに{"kind": "artifacts", "fromRunArtifacts": {"runId": "<Run ID>", "prefix": "outputs/audio"}}を指定すると、RunのArtifactのうちprefixの下にあるファイルでバージョンを作ります
result.jsonの書き方はTaskとコードバージョンを参照してください。推論のRunの出力を評価のRunへ自動で渡す方法は自動実行にあります。
どのRunで使ったかを確かめる
バージョンを選ぶと、詳細の下に「このバージョンを入力にしたRun」が出ます。Run名を押すとそのRunへ移ります。[Lineageで見る]を押すと、Lineageをこのバージョンの前後2段だけに絞って表示します(親のバージョン、入力にしたRun、そのRunが作ったモデルなど)。[全体を表示]で元に戻ります。
Runの入力にする
Taskの実行や自動実行のruleで、入力にするデータセットのバージョンを選びます。workerは実行コードを起動する前に、バージョンの本体をGPUマシンの作業ディレクトリへ用意し、中身を確かめます。
| バージョン | workerが行うこと |
|---|---|
| Artifactを本体とするバージョン | ファイルを取得し、digestと各ファイルのSHA-256、サイズを照合します |
file://の参照 | コンピュータにあるパスをそのまま使います。コピーしません |
https://の参照 | 認証なしで1つのファイルを取得します。digestがSHA-256なら照合します |
s3://の参照 | コンピュータの環境変数AWS_ACCESS_KEY_ID、AWS_SECRET_ACCESS_KEY、AWS_ENDPOINT_URL_S3などで認証して取得します |
urn:、mmt-artifact:の参照 | 取得しません |
用意できなかった場合(取得の失敗、照合の不一致、対応していないURI)は、実行コードを起動せずにJobを失敗にします。理由はRunの[Logs]に表示されます。
実行コードは、環境変数MMT_INPUT_DATASET_DIRS(バージョンのIDとディレクトリのJSON)で本体の場所を知ります。ディレクトリは読み取り専用です。
import json, os, pathlib

for version_id, directory in json.loads(os.environ.get("MMT_INPUT_DATASET_DIRS", "{}")).items():
    for wav in sorted(pathlib.Path(directory).rglob("*.wav")):
...DockerやSingularity、Apptainerで動かす場合、本体は/mmt/datasets/<バージョンのID>に置かれます。
コンピュータへの送り方とキャッシュ
コンピュータの編集画面で、[データセットの転送]と[データセットのcache上限(GiB)]を設定します。
| データセットの転送 | 内容 |
|---|---|
| workerが中継する(既定) | workerがAPIから取得し、まとめてGPUマシンへ送ります。GPUマシンからAPIへつながらなくても使えます。worker側にも一時的にバージョン1つ分の空き容量が必要です |
| コンピュータがAPIから直接取得する | GPUマシンがJob限定のtokenでAPIから取得します。GPUマシンからAPIへつながる必要があります |
取得した本体は、コンピュータの<作業ディレクトリ>/.mmt-cache/datasets/にキャッシュします。同じバージョンを使う次のJobは、取得し直さずにキャッシュを使います。キャッシュの合計がcache上限(既定100 GiB)を超えると、最後に使った日時が古いものから削除します。実行中のJobが使っているバージョンは削除しません。1つのバージョンがcache上限より大きい場合は、Jobを失敗にします。
コンピュータの設定はSSH・Localのコンピュータを参照してください。
Madoのデータセットを使う
全体管理者がProjectのMado連携を設定して有効にしていると、Madoで管理しているデータセットのバージョンを取り込めます。Mado連携は最初は無効で、無効の間は[Madoからインポート]と[Madoで見る]は出ません。
- [Datasets]の[Madoからインポート]を押します。[連携]の画面が開きます
- [接続を確認]を押します。成功すると検索できるようになります
- 「データセットを検索」に名前を入れて[検索]を押します
- 取り込むバージョンの行で[インポート]を押します
取り込んだバージョンは参照のバージョンになり、Madoでの名前、Namespace、バージョンを保ちます。同じバージョンをもう一度取り込んでも、バージョンは増えません。[Madoからインポート]はProject adminに表示されます。取り込んだバージョンを選ぶと[Madoで見る]が出て、Madoでそのバージョンを開けます。Mado側では本人のログインと権限が必要です。
連携が有効な間は、Runが始まったときと終わったときに、Runの入力と出力のバージョンがMadoへ送られます。Madoのデータセットのlineageから、どの実験で使ったかを確かめられます。連携の設定と有効化はMado連携を参照してください。
使わなくなったデータセット
データセットは削除できません。バージョンは、どこからも使われていなければ削除できます。URIを打ち間違えたバージョンなどは、バージョンを選んで[このバージョンを削除]を押し、確認で[削除する]を押します(Editor以上)。Runの入力・出力、ほかのバージョンの親、Task・自動実行ルール・フックの入力などから使われているときは、「このバージョンは使われているため削除できません(Runの入力 1件)」のように、何が使っているかを表示して断ります。削除しても、URIの先のデータとArtifactは消えません。APIではDELETE /api/projects/<Project ID>/datasets/<Dataset ID>/versions/<バージョンのID>です。
使わなくなったデータセットは、名前の横の[⋯]→[アーカイブ]で、確認のあとアーカイブします(editor以上)。アーカイブしたデータセットのバージョンは、新しいRun・Task・自動実行ルール・フックの入力に選べなくなります。作成済みのRunの記録とバージョンはそのまま残ります。アーカイブしたデータセットは開いたままになり、アーカイブしたことを知らせます。一覧からは既定で隠れ(開いている間は出ます)、[アーカイブ済みも表示]で出します。戻すときは[⋯]→[アーカイブを解除]です。APIではPATCH /api/projects/<Project ID>/datasets/<Dataset ID>に{"archived": true}(解除はfalse)を送ります。
バージョンが参照しているArtifactは、バージョンがある限り削除できません。
関連するページ
登録済みの版に生成元を追加する
過去の加工音声や生成設定を照合して、親の登録漏れが分かったときに使います。版を作り直さず、現在の版ID・保存先・ハッシュと、学習Runからの参照を保ったまま親を補足できます。
- Datasetsで対象のバージョンを開き、[親データ版を追加]を押します。
- 照合済みの親データ版を選び、追加する理由とJSON形式の照合根拠を入力します。
- 保存後、[親]と[親の追記履歴]に表示されることを確認します。Lineageとモデルの学習元からも生成元を辿れます。
照合根拠には保存済み設定、参照先、SHA-256、件数などを記録します。未知の生成者や日時を推測で埋めないでください。学習中に利用データを切り替えた記録は、Runの[学習データの履歴]で別に管理します。
同じProjectの親だけ追加でき、循環する関係は拒否されます。同じ親を再送しても重複せず、最初の理由・根拠・追加した人・日時を保持します。追加した親と、訂正履歴を持つ版は削除から保護されます。編集はProjectのeditor以上、API tokenはregistry:writeが必要です。
client.add_dataset_version_parents(
    project_id, dataset_id, feature_version_id,
    parent_dataset_version_ids=[processed_audio_version_id],
    reason="保存済みの生成設定から、親の登録漏れを確認",
    evidence={"recipe": "保存済み設定の参照", "archive_count": 32},
)