MLflow 3から記録する
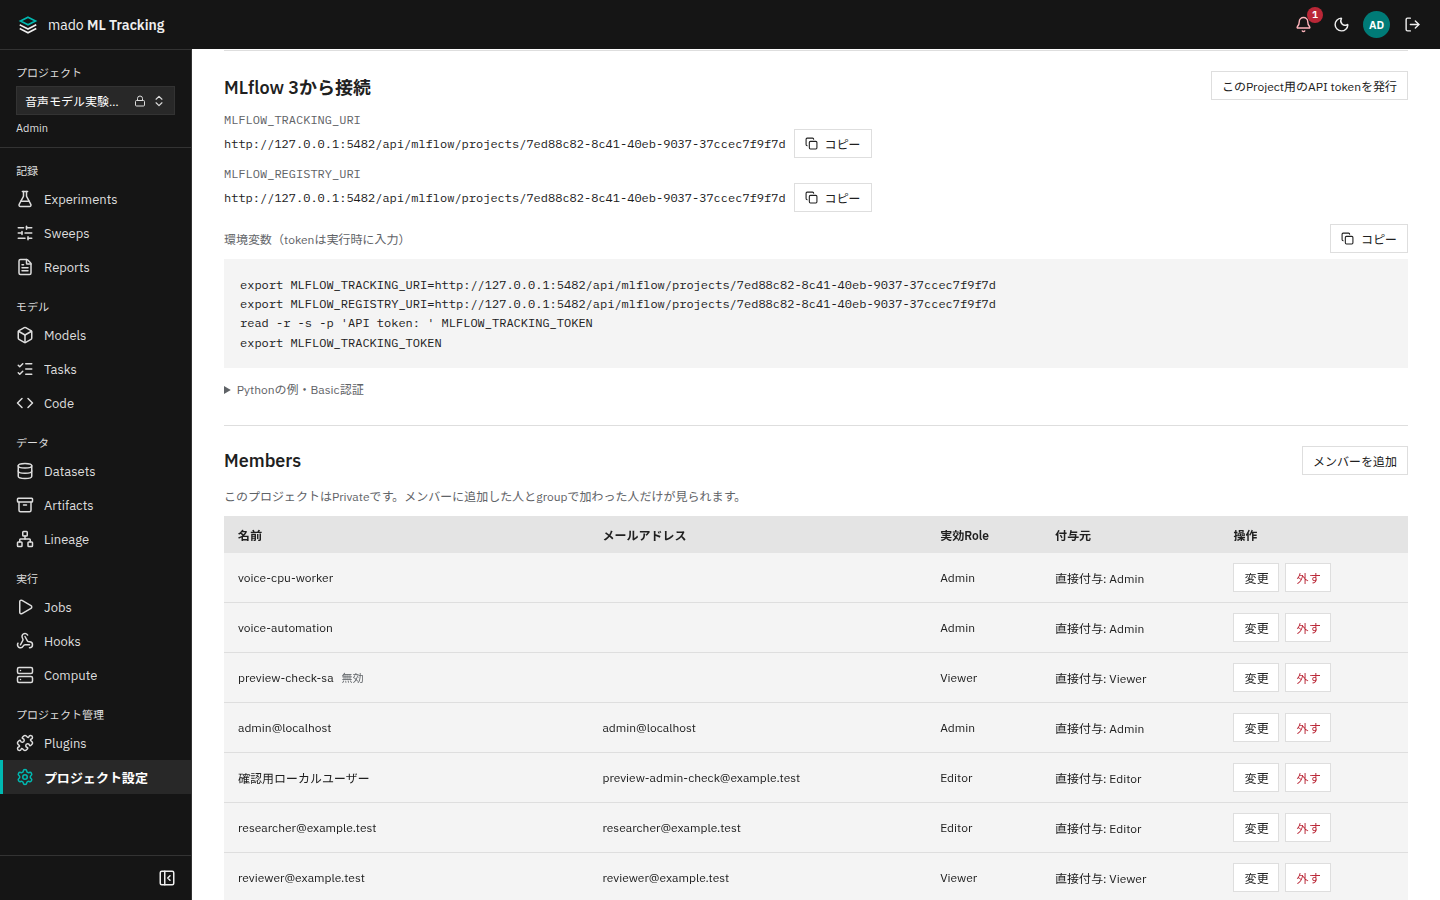
公式のmlflow Python SDK(MLflow 3)から、mado ML TrackingのProjectへ記録できます。接続先とtokenを環境変数で指定するだけで、既存のMLflowのコードを変えずに使えます。記録したRun・metrics・Artifact・登録モデルは、画面から記録したものと同じデータとして扱います。
MLflowの全機能を提供するサーバーではありません。対応している機能は対応範囲の表で確認してください。
こんなときに向いています
- 今あるMLflowの学習コードを、そのまま社内のサーバーへ記録したい
mlflow.sklearn.autolog()などの自動記録を使いたいmlflow.register_model()で登録したモデルを、そのまま自動推論・自動評価につなげたい
接続する
- [プロジェクト設定]を開き、「SDK・MLflow 3から接続」の[MLflow 3]を確認します(実験の画面の[SDKで記録]からも開けます。そこでは
set_experimentの例に開いている実験の名前が入ります)。MLFLOW_TRACKING_URIとMLFLOW_REGISTRY_URIには同じURL(https://<サーバー>/api/mlflow/projects/<ProjectのID>)が表示されます - [このProject用のAPI tokenを発行]を選びます。scopeに
read・runs:write・registry:write・artifacts:writeが選ばれた状態で発行画面が開くので、名前と期限を入力して発行します。tokenはこのときだけ表示されるので控えておきます(ボタンはeditor以上にだけ表示されます) - 学習を実行するマシンのターミナルで、MLflowをインストールして環境変数を設定します
python3 -m pip install 'mlflow>=3,<4'
export MLFLOW_TRACKING_URI='https://tracking.example.internal/api/mlflow/projects/PROJECT_ID'
export MLFLOW_REGISTRY_URI="$MLFLOW_TRACKING_URI"
printf 'API token: '; read -r -s MLFLOW_TRACKING_TOKEN; echo
export MLFLOW_TRACKING_TOKEN
画面の[環境変数(tokenは実行時に入力)]の右の[コピー]で、このProjectのURLが入った設定例をコピーできます。tokenはソースコードやGitで管理するファイルに書かず、コンテナには環境変数として渡してください。
| 用途 | 必要なscope |
|---|---|
| Experiment・Run・モデル・Artifactの読み出し | read |
| Experiment・Run・params・metrics・tagsの記録 | runs:write |
| 入力Datasetの新規登録 | runs:writeとregistry:write |
| Artifactのアップロード | artifacts:write |
| Logged Model・モデルバージョン・aliasの登録や変更 | registry:write |
記録するユーザーには、そのProjectのeditor以上の役割が必要です。Workerや自動処理のように長く動かすものには、人ではなくService Accountのtokenを使ってください。SSOでログインするユーザーのtokenは、グループの確認から7日を過ぎると止まります(API token)。
接続を確かめる
次のコードを実行し、画面の[Experiments]にconnection-checkのExperimentとRunが出れば接続できています。
import mlflow

mlflow.set_experiment("connection-check")
with mlflow.start_run(run_name="hello"):
    mlflow.log_param("learning_rate", 0.01)
    mlflow.log_metric("loss", 0.5, step=1)
うまくいかないときは、エラー文に直す所が書いてあります。
| エラー | 直す所 |
|---|---|
ENDPOINT_NOT_FOUND: MLFLOW_TRACKING_URIにProjectのIDが入っていません | MLFLOW_TRACKING_URIをサイトや/api/mlflowで止めず、/api/mlflow/projects/<ProjectのID>まで入れる |
UNAUTHENTICATED: API tokenが送られていません | MLFLOW_TRACKING_TOKEN(Basic認証ならMLFLOW_TRACKING_PASSWORD)にtokenを入れる |
UNAUTHENTICATED(tokenが無効または失効) | tokenの値か期限を確かめ、必要なら発行し直す |
PERMISSION_DENIED: API tokenのscopeが不足しています | 足りないscopeが書いてある。用途「SDK・MLflow 3から記録する」でtokenを発行し直す |
PERMISSION_DENIED: API tokenのprojectが一致しません | tokenがどのProject用かが書いてある。URIのProject IDか、使うtokenを合わせる |
Basic認証で接続する
ユーザー名とパスワードしか設定できない社内ツールでは、Basic認証も使えます。パスワードにAPI tokenを入れます。ユーザー名は照合しないので、任意の値で構いません。
export MLFLOW_TRACKING_URI='https://tracking.example.internal/api/mlflow/projects/PROJECT_ID'
export MLFLOW_TRACKING_USERNAME=mado
printf 'API token: '; read -r -s MLFLOW_TRACKING_PASSWORD; echo
export MLFLOW_TRACKING_PASSWORD- Basic認証を使えるのは、MLflow互換の接続先(
/api/mlflow/...)だけです - ローカルアカウントのパスワードを入れても接続できません
- 失効・期限・scope・Projectの役割の確認は、
MLFLOW_TRACKING_TOKENのときと同じです
設定例は、画面の[Service Accountのtoken・Basic認証]を開くと表示されます。
RunとArtifactを記録する
from pathlib import Path
import mlflow

mlflow.set_experiment("qwen3-finetuning")
with mlflow.start_run(run_name="learning-rate-2e-5"):
    mlflow.log_params({"learning_rate": 2e-5, "epochs": 3})
    mlflow.set_tags({"model_family": "qwen3", "dataset": "training-v1"})
    mlflow.log_metric("train.loss", 0.42, step=100)
    mlflow.log_metric("train.loss", 0.31, step=200)
    Path("predictions.json").write_text('{"text": "sample"}')
mlflow.log_artifact("predictions.json", artifact_path="evaluation")- 同じparamに違う値を記録するとエラーになります。条件を変えた実験は新しいRunにしてください
- metricsの最新の値は、届いた順ではなくstepと時刻で決まります。NaNも保存できます
- Runの終わりにSDKが表示する
View run・View experimentのリンクを開くと、このアプリのRunの画面・[Experiments]の画面が開きます - Artifactは管理者が選んだ保存先(ファイルシステムかS3互換ストレージ)に保存します。SDKにストレージの認証情報を渡す必要はありません
mlflow.start_run(run_id="RUN_ID")で、終わったRunを開き直して続きを記録できます。WorkerのJobで動いたRunは開き直せません
大きいファイルは、MLflowのmultipart uploadで分割して送れます。MLflow 3.17以降のSDKは自動で使います。3.0〜3.16ではMLFLOW_ENABLE_PROXY_MULTIPART_UPLOAD=trueを設定してください。既定ではSDKは500MiB以上のファイルを10MiBずつに分けて送ります。partの大きさ(MLFLOW_MULTIPART_UPLOAD_CHUNK_SIZE)は5MiB以上にし、part数は10,000までなので、200GiBのファイルなら21MiB以上にします。詳しくは大きなファイルのアップロードを参照してください。
autologを使う
scikit-learnでは、次のようにparams・metrics・入力Dataset・モデルを自動で記録できます。
import mlflow
import mlflow.sklearn

mlflow.set_experiment("automatic-training")
mlflow.sklearn.autolog(log_models=True, log_datasets=True)
model.fit(features, targets)
確認済みのautologはscikit-learnだけです。ほかのライブラリのautologは使うAPIやモデル形式が違うため、動作を確かめていません。
モデルを登録する
import mlflow
import mlflow.sklearn
import numpy as np
from sklearn.linear_model import LinearRegression

features = np.array([[0.0], [1.0], [2.0]])
targets = np.array([1.0, 3.0, 5.0])
with mlflow.start_run():
    mlflow.log_input(mlflow.data.from_numpy(features, targets=targets, name="training-v1"), context="training")
    model = LinearRegression().fit(features, targets)
    recorded = mlflow.sklearn.log_model(model, name="regression")

version = mlflow.register_model(recorded.model_uri, "regression")
mlflow.MlflowClient().set_registered_model_alias("regression", "candidate", version.version)
loaded = mlflow.pyfunc.load_model("models:/regression@candidate")- バージョンの番号は1、2、3…と自動で付きます。画面から登録したバージョンと同じ系列で数え、削除したバージョンの番号は再利用しません
- 登録したバージョンは、モデル一式のファイルをバージョンごとに固定します。元のRunのファイルを上書きしても、バージョンの内容は変わりません
- 読み込みには
models:/名前/バージョンかmodels:/名前@aliasを使います - 入力Dataset、生成元のRun、登録したバージョンの関係は[Lineage]に表示します
save_model()で保存したディレクトリをlog_artifacts()でRunに上げた場合も、そのまま登録できます。
mlflow.sklearn.save_model(model, "saved")
with mlflow.start_run() as run:
    mlflow.log_artifacts("saved", "model")
version = mlflow.register_model(f"runs:/{run.info.run_id}/model", "regression")- 登録のときにディレクトリの
MLmodelを読み、そこに書かれたファイルをモデル本体(Modelsの画面の重み)にします。生成元のRunもバージョンに結び付きます - 戻り値の
sourceは、登録時に固定したファイル一式の場所(mlflow-artifacts:/model-versions/…)です。MLflowのサーバーと違い、指定したruns:/…ではありません
登録をきっかけに推論・評価を自動で動かすには、登録モデルのtag mmt.model_familyに系列名を指定し、その系列の自動実行ルールをProjectに用意します。
mlflow.MlflowClient().create_registered_model("qwen3", tags={"mmt.model_family": "qwen3"})ルールの作り方はモデルと自動実行を参照してください。
表・画像・音声を記録する
log_table・log_image・log_dict・log_text・log_figureで記録したものは、Artifactとして一覧・ダウンロードできますlog_image(image, key=..., step=...)の画像とlog_tableの表は、Runの[Media]タブにも出ます(メディアの記録と聴き比べ)。MLflow 3.0.0では、keyに/を含めないでください(SDKがファイル名を切ってしまいます)。3.17.0以降は問題ありません- 音声は
mlflow.log_artifactで保存します。wav・flacは画面でそのまま再生できます
対応範囲
MLflow 3.0.0(scikit-learn 1.6.1)と3.17.0(scikit-learn 1.9.1)で動作を確かめた範囲です。この表に無い機能は確かめていません。
| 機能 | 状態 |
|---|---|
| Run・nested Run・params・metrics・tags、検索、削除と復元 | 対応 |
| Artifactのアップロード・ダウンロード、multipart upload | 対応 |
| Logged Model、Model Registry、alias | 対応 |
| scikit-learnのautolog | 対応 |
mlflow.models.evaluate(結果はRunとLogged Modelに記録) | 対応 |
log_table・log_image・log_dict・log_text・log_figure | 対応 |
| wav・flacの音声Artifact | 対応 |
| 自作のpyfuncモデル、複数ファイルのモデル | 対応 |
save_model()で保存しlog_artifacts()で上げたモデルのregister_model("runs:/…") | 対応 |
最初のRunの前のmlflow.search_runs()・get_experiment("0") | 対応(0件、空のDefault Experimentを返します) |
mlflow.search_runsのpandas出力 | 対応 |
登録モデル・バージョンの検索(search_registered_models、search_model_versions) | 対応(1回に返すのは最大1000件。下の説明を参照) |
SDKが表示するView run・View experimentのリンク | 対応(このアプリの画面が開きます) |
| webhooks | 未対応(ENDPOINT_NOT_FOUNDのエラー) |
Tracing(search_traces、@mlflow.trace) | 未対応。@mlflow.traceを付けた関数は動き、Runも正常に終わります |
| GenAI評価、AI Gateway、Prompt Registry | 未対応 |
検索の条件はANDでつなぎます。ORと括弧は使えません。IN/NOT INはrun_idなどの一部の属性で使えます。
- tagの条件は、MLflowと同じく
tags.名前とtag.名前のどちらでも書けます - バージョンの番号は
version_numberで指定します(例:version_number > 2、order_by=["version_number DESC"]) - 登録モデル・バージョン・Logged Modelの検索は、1回に最大1000件を返し、残りがあれば続きのページの印(
next_page_token)を付けます。mlflow.search_model_versions()などのmlflow.で始まる関数は、続きを自動でたどって全件を返します MlflowClient().search_model_versions()は1ページ分(1000件まで)だけを返します。MLflowのサーバーは10000件まで1回で返すので、ここだけ違います。1000件を超えるときは、戻り値のtokenをpage_tokenに渡して続きを取ってください
Workerの中で使う
Workerで動くJobには、MLflowの接続先・token・Experiment・Runが環境変数で渡されます。コードのmlflow.start_run()は新しいRunを作らず、Jobに割り当てられたRunに記録します。tokenはそのRunだけを書けるJob限定のものです。Jobの環境にMLflow 3を入れておいてください(Worker)。